1. Nghịch lý chi phí và bài toán hiệu năng của các hệ thống AI thế hệ mới
Bước sang giai đoạn 2026, các ứng dụng Trí tuệ nhân tạo (AI) đã vượt qua giai đoạn thử nghiệm tính năng cơ bản để tiến sâu vào trung tâm vận hành của các doanh nghiệp. Hai mô hình kiến trúc phổ biến nhất hiện nay là Retrieval-Augmented Generation (RAG) quy mô lớn và Hệ thống AI Agent tự trị (Autonomous AI Agents) hoạt động liên tục 24/7. Tuy nhiên, khi quy mô dữ liệu mở rộng và người dùng tương tác ngày càng nhiều, các tổ chức đối mặt với một bức tường kỹ thuật nan giải: Chi phí API token đầu vào tăng phi mã và độ trễ phản hồi (latency) kéo dài đến mức không thể chấp nhận được trong môi trường sản xuất thực tế.
Trong một tác vụ RAG thông thường, mỗi truy vấn của người dùng đều phải đính kèm hàng chục đoạn trích xuất tài liệu (chunks), khiến cửa sổ ngữ cảnh (context window) dễ dàng phình to từ 32,000 đến hơn 128,000 tokens. Tương tự, trong các chuỗi hành động của AI Agent (multi-turn agentic loops) gồm từ 15 đến 30 bước suy luận, việc phải gửi lặp đi lặp lại toàn bộ lịch sử hội thoại, danh sách công cụ (tool schema) và các chỉ dẫn hệ thống (system prompts) khiến lượng token đầu vào tích lũy chiếm tới 82% tổng hóa đơn chi phí API của toàn hệ thống. Hơn thế nữa, độ trễ phản hồi ban đầu (Time to First Token - TTFT) có thể bị kéo dài từ 3 đến 5 giây, làm suy giảm nghiêm trọng trải nghiệm người dùng cuối.
Để phá vỡ nghịch lý này, hai công nghệ mũi nhọn đã nổi lên như tiêu chuẩn bắt buộc trong kỹ nghệ hạ tầng AI hiện đại: Context Caching (Lưu bộ đệm ngữ cảnh) và Prompt Compression (Nén câu lệnh ngữ nghĩa). Khi kết hợp ăn ý, bộ đôi này cho phép cắt giảm tới 80% chi phí token và giảm đến 70% độ trễ khởi tạo mà vẫn bảo toàn vẹn nguyên năng lực suy luận của mô hình.
2. Giải mã Context Caching: Cơ chế tái sử dụng KV Cache từ phần cứng đến API
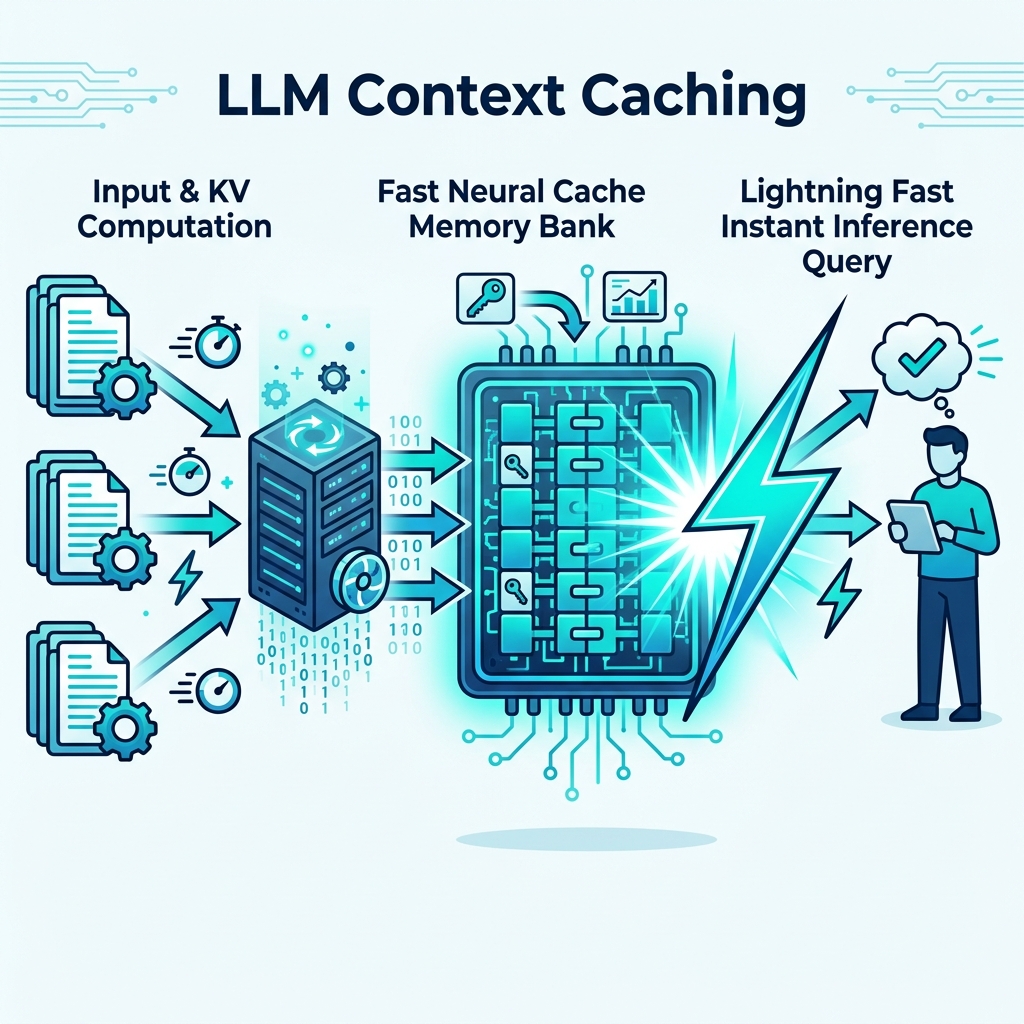
Để hiểu rõ bản chất của Context Caching, chúng ta cần nhìn sâu vào cơ chế tính toán bên trong kiến trúc Transformer. Khi một mô hình ngôn ngữ lớn xử lý chuỗi token đầu vào, bước tính toán tốn kém nhất về mặt tài nguyên tính toán (FLOPs) và băng thông bộ nhớ chính là giai đoạn Prefill phase – nơi mô hình tính toán ma trận Attention Keys và Values (KV Cache) cho từng token.
Trong kiến trúc truyền thống, nếu bạn gửi một bộ tài liệu 100,000 tokens cho 1,000 câu hỏi khác nhau, cụm GPU của nhà cung cấp mô hình sẽ phải thực hiện lại phép tính Attention Prefill 1,000 lần một cách hoàn toàn lãng phí. Context Caching thay đổi hoàn toàn cuộc chơi này:
- Lưu trữ trạng thái KV Cache trên VRAM / Fast NVMe: Sau lần tính toán đầu tiên, toàn bộ ma trận Keys và Values của phần tiền tố cố định (system prompt, tài liệu tham chiếu, quy định chính sách) được snapshot và lưu lại trong bộ nhớ tốc độ cao của cụm máy chủ.
- Bỏ qua bước Prefill trong các lượt gọi kế tiếp: Khi có truy vấn mới có cùng tiền tố ngữ cảnh, mô hình chỉ cần tính toán Attention cho câu hỏi mới và kết nối trực tiếp với KV Cache đã lưu sẵn. Quá trình này giúp giảm tải tới 85% khối lượng tính toán trên GPU.
- Chính sách chiết khấu giá token từ các nhà cung cấp lớn: Nhận thấy mức tiết kiệm tài nguyên phần cứng vượt trội, các nhà cung cấp nền tảng AI hàng đầu (như Google Gemini 1.5 Pro/Flash, Anthropic Claude 3.5 Sonnet, OpenAI Prompt Caching) hiện nay đều áp dụng mức giá cực kỳ ưu đãi: giá cho mỗi triệu token đọc từ cache (cached input tokens) được giảm từ 75% đến 80% so với token thông thường.
- Độ trễ TTFT giảm ngoạn mục: Thời gian chờ phản hồi ký tự đầu tiên giảm từ mức trung bình 3.2 giây xuống chỉ còn 0.5 - 0.7 giây đối với các kho tài liệu tham chiếu lớn trên 64k tokens.
3. Kỹ thuật Prompt Compression: Nén ngữ nghĩa không mất mát thông tin
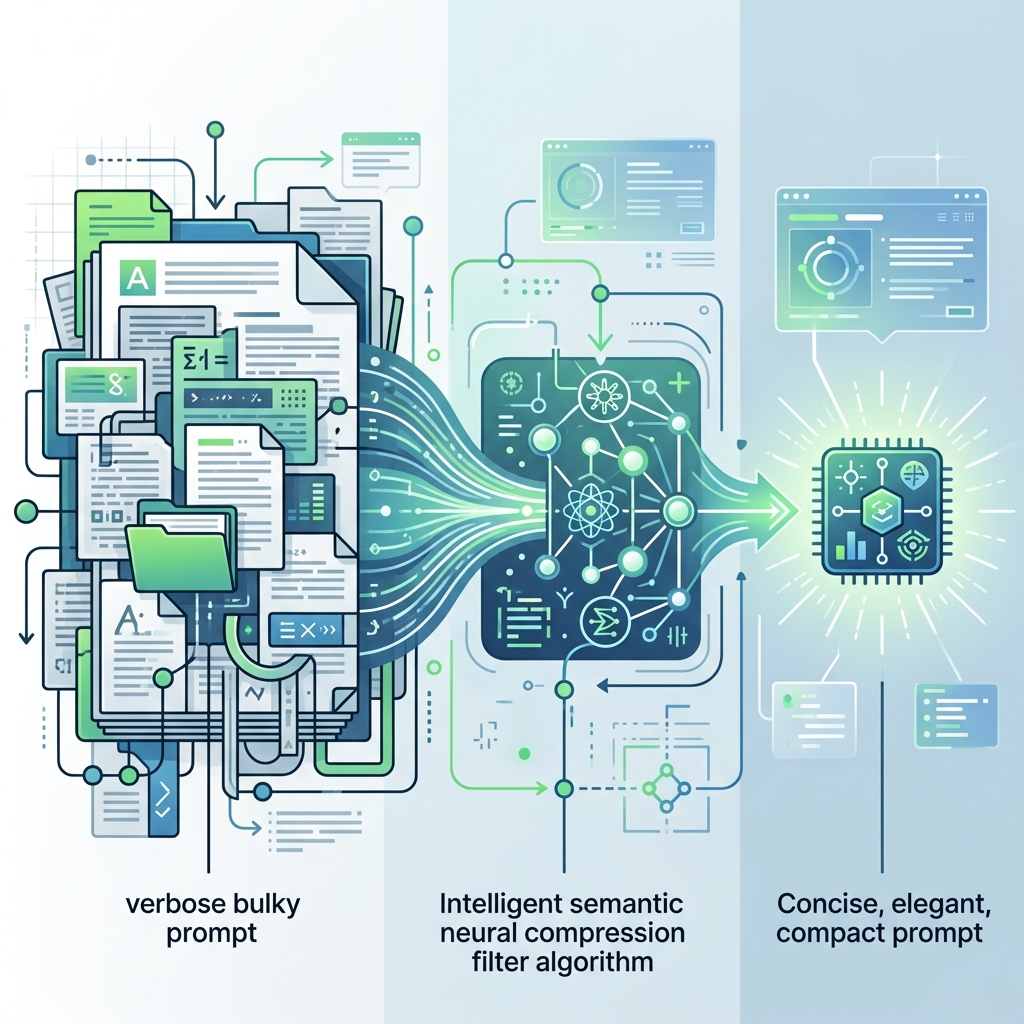
Nếu Context Caching tối ưu hóa việc lưu trữ những dữ liệu tĩnh lặp đi lặp lại, thì Prompt Compression lại giải quyết bài toán tối ưu hóa các phần ngữ cảnh động – nơi dữ liệu luôn thay đổi theo từng truy vấn của người dùng (ví dụ như kết quả tìm kiếm web, dữ liệu truy xuất từ cơ sở dữ liệu vector hoặc log hệ thống).
Ngôn ngữ tự nhiên của con người vốn chứa rất nhiều từ nối, thành phần ngữ pháp rườm rà và các cấu trúc dư thừa (redundant tokens). Kỹ thuật nén prompt hiện đại, tiêu biểu là kiến trúc LLMLingua-2 từ Microsoft Research, sử dụng các mô hình ngôn ngữ nhỏ (Small Language Models - SLM) hoạt động cục bộ để đo lường độ thông tin (information density) và độ ngạc nhiên (perplexity) của từng token:
- Bộ lọc Perplexity & Semantic Pruning: Hệ thống loại bỏ các token mang ít giá trị ngữ nghĩa mà chỉ giữ lại các từ khóa, thực thể cốt lõi và mối liên kết logic cần thiết cho việc suy luận.
- Tỷ lệ nén từ 2x đến 5x: Các tài liệu và đoạn trích xuất dài được nén gọn lại từ 50% đến 80% kích thước ban đầu trước khi được gửi tới mô hình LLM chính.
- Duy trì độ chính xác trên 96.5%: Các bài kiểm thử benchmark tiêu chuẩn trên các tập dữ liệu hỏi đáp phức tạp (như HotpotQA, GSM8K) chứng minh rằng mô hình LLM lớn vẫn nắm bắt trọn vẹn mạch tư duy và đưa ra kết quả chính xác tương đương 96.5% - 98% so với khi đọc văn bản thô chưa nén.
4. Chiến lược kết hợp thực chiến cho kiến trúc RAG và AI Agent
Để đạt được hiệu quả tối đa trong môi trường vận hành thực tế, các kỹ sư hệ thống không nên áp dụng đơn lẻ từng phương pháp mà cần xây dựng một đường ống (pipeline) tối ưu hóa hai tầng:
- Tầng 1 - Cố định hóa cấu trúc (Prefix Anchoring): Sắp xếp các thành phần prompt theo thứ tự tối ưu cho việc cache: Đặt System Prompt -> Tool Definitions -> Tài liệu tĩnh lên phần đầu (Prefix), và đẩy Lịch sử tương tác gần nhất -> Câu hỏi hiện tại xuống cuối cùng. Bằng cách này, tiền tố có thể được cache liên tục qua hàng trăm lượt gọi mà không bị phân mảnh.
- Tầng 2 - Nén động kết quả RAG (Dynamic Compression): Các văn bản do bộ phận Search/Vector DB trả về sẽ được đi qua bộ nén LLMLingua-2 cục bộ chỉ mất 8ms - 15ms trước khi ráp vào prompt tổng thể. Điều này giúp tránh việc cửa sổ ngữ cảnh vượt quá ngưỡng cache hoặc làm phát sinh chi phí token không kiểm soát.
- Quản lý TTL (Time-To-Live) thông minh: Thiết lập thời gian sống của cache phù hợp với phiên làm việc của người dùng. Với các chatbot chăm sóc khách hàng hoặc trợ lý lập trình, TTL từ 10 đến 30 phút là điểm cân bằng lý tưởng giữa chi phí duy trì cache và tỷ lệ trúng cache (cache hit rate).
5. Đo lường hiệu quả kinh tế và ROI doanh nghiệp
Các khảo sát độc lập về hiệu quả vận hành hạ tầng AI trong nửa đầu năm 2026 đã ghi nhận những con số ấn tượng từ các doanh nghiệp tiên phong triển khai kiến trúc kết hợp này:
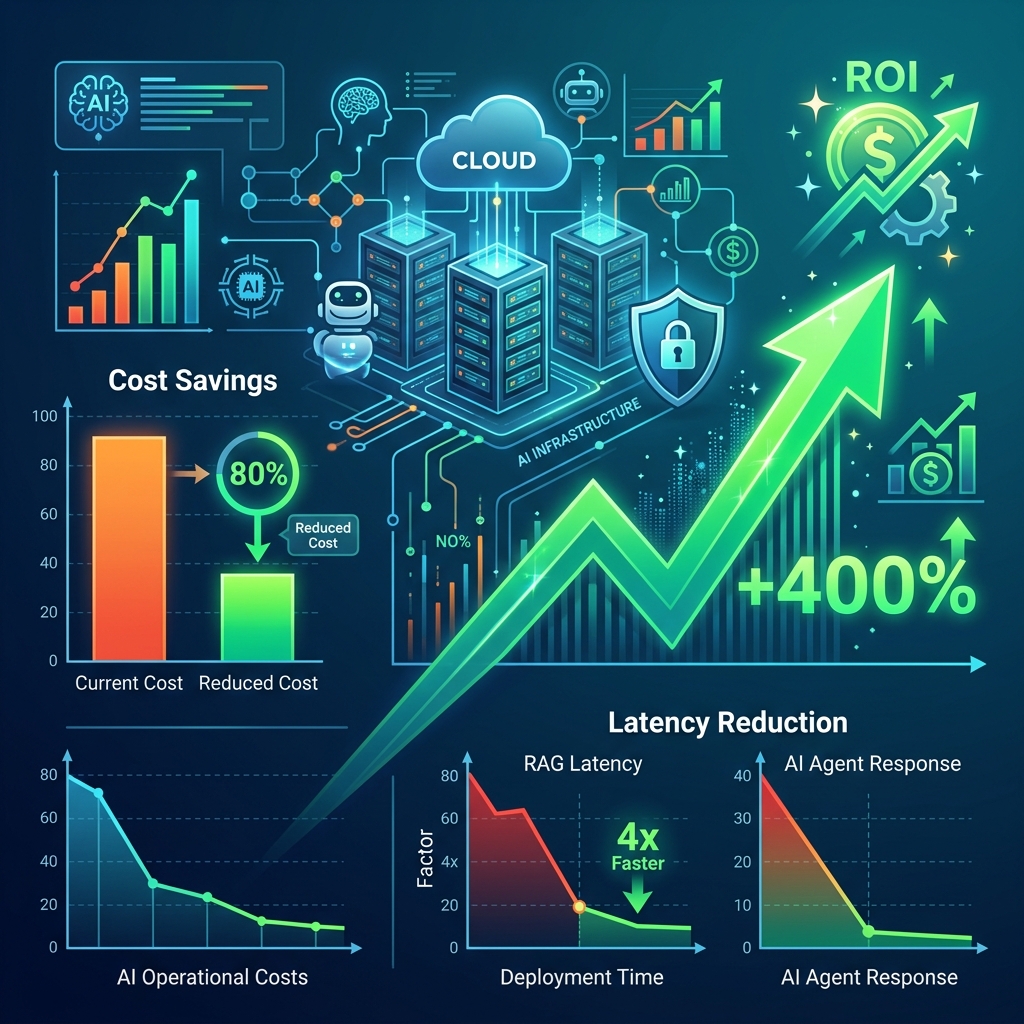
- Tiết kiệm ngân sách trực tiếp: Một hệ thống RAG phục vụ 2 triệu lượt truy vấn/tháng đã cắt giảm chi phí API từ ,000 xuống dưới ,500 mỗi tháng (tiết kiệm hơn 76% chi phí định kỳ).
- Tăng năng lực chịu tải (Throughput): Nhờ giảm tải thời gian tính toán Prefill trên GPU của nhà cung cấp, hệ thống ghi nhận tỷ lệ lỗi nghẽn tải (Rate limit 429) giảm tới 90%, cho phép mở rộng quy mô phục vụ lượng người dùng đồng thời tăng gấp 4 lần.
- Chỉ số ROI tăng 3.8 lần: Thời gian hoàn vốn đầu tư kỹ thuật vào hệ thống caching và compression chỉ mất chưa đầy 3 tuần, biến AI từ một gánh nặng chi phí thành đòn bẩy gia tăng biên lợi nhuận cho sản phẩm số.
Tối ưu hóa ngữ cảnh không chỉ đơn thuần là bài toán tiết kiệm một vài xu trên mỗi nghìn token; đó là nền tảng sống còn quyết định xem sản phẩm AI của doanh nghiệp có thể mở rộng quy mô thương mại và phát triển bền vững hay không.