1. Cú sốc chuyển giao: Tại sao 72% ứng dụng AI thất bại khi rời khỏi phòng thí nghiệm?
Bước sang năm 2026, các mô hình ngôn ngữ lớn (LLM) và hệ thống tác nhân AI (Agentic AI) đã chứng minh tiềm năng phi thường qua các bản trình diễn mẫu (Proof-of-Concept - PoC). Tuy nhiên, khi các nhóm kỹ thuật phần mềm cố gắng đưa ứng dụng AI vào môi trường sản xuất thực tế (production) phục vụ hàng triệu người dùng, họ lập tức đối mặt với một thực tế khắc nghiệt: Hơn 72% các dự án GenAI bị đình trệ hoặc thất bại sau khi triển khai.
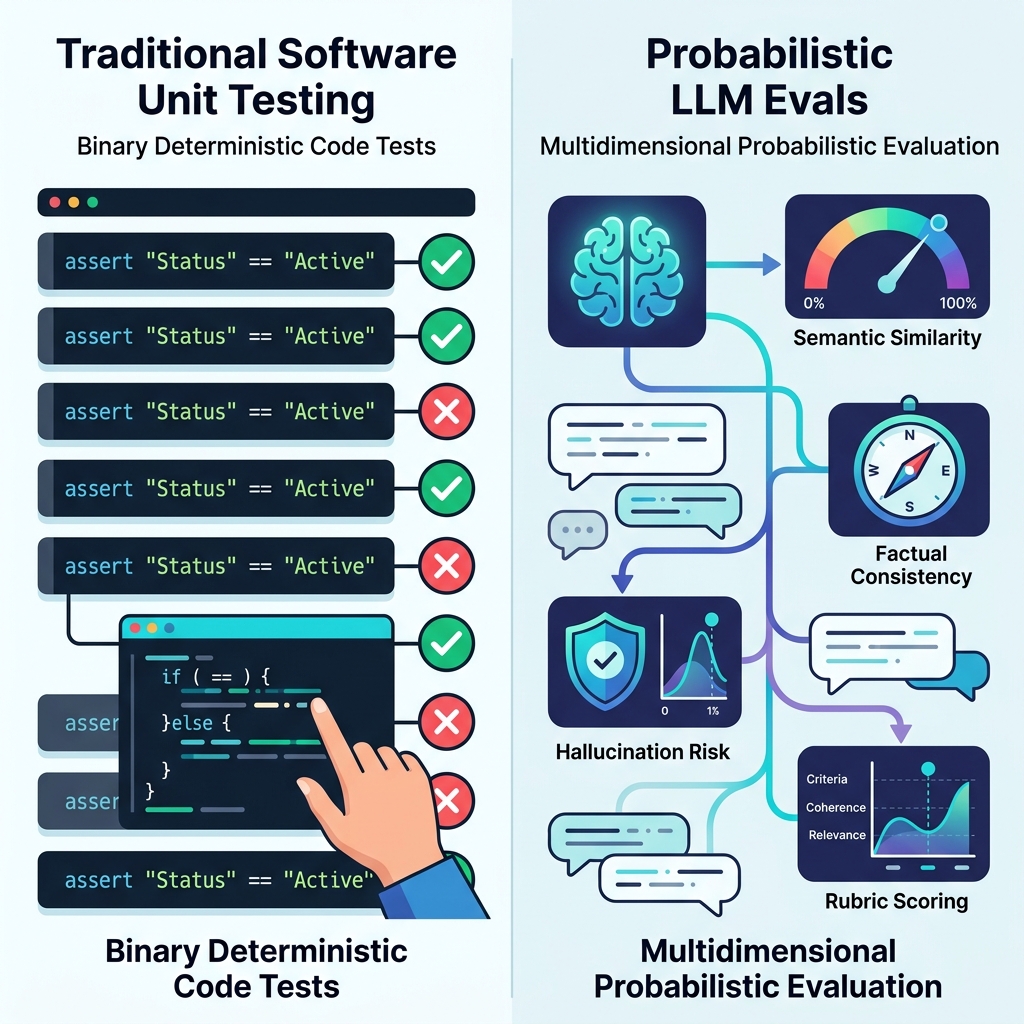
Nguyên nhân cốt lõi không nằm ở năng lực của mô hình, mà bắt nguồn từ sự sụp đổ của tư duy kiểm thử phần mềm truyền thống. Suốt nhiều thập kỷ, ngành công nghệ dựa vào các bài kiểm thử tất định (deterministic testing): với cùng một tham số đầu vào, hệ thống phải trả về chính xác cùng một kết quả (`assert response.status == 200`). Nhưng LLM là những cỗ máy xác suất (probabilistic engines). Cùng một câu hỏi, câu trả lời có thể thay đổi cách dùng từ, cấu trúc câu hoặc ngữ điệu qua mỗi lần gọi. Các bộ test case viết tay kiểu so khớp chuỗi (string matching) hoàn toàn bất lực trong việc xác định xem câu trả lời của AI có đúng đắn, an toàn và mạch lạc hay không.
Tệ hại hơn, khi hệ thống AI vận hành liên tục trong 3 đến 6 tháng, hiện tượng trôi dữ liệu (Data Drift) và trôi mô hình (Model Drift) âm thầm diễn ra. Các nghiên cứu thực nghiệm năm 2026 ghi nhận: Tỷ lệ ảo giác (hallucination rate) của các hệ thống AI không được giám sát có thể tăng vọt từ mức chấp nhận được 3.5% lên tới 18.2%, gây ra những rủi ro pháp lý và tổn thất tài chính nghiêm trọng cho doanh nghiệp. Để giải quyết triệt để rào cản này, Kỹ nghệ Đánh giá Liên tục (Continuous LLM Evals) đã trở thành tiêu chuẩn kỹ thuật sống còn của các đội ngũ kỹ sư phần mềm hiện đại.
2. Bóc tách kiến trúc Continuous Evals: Từ CI/CD đến Production Observability
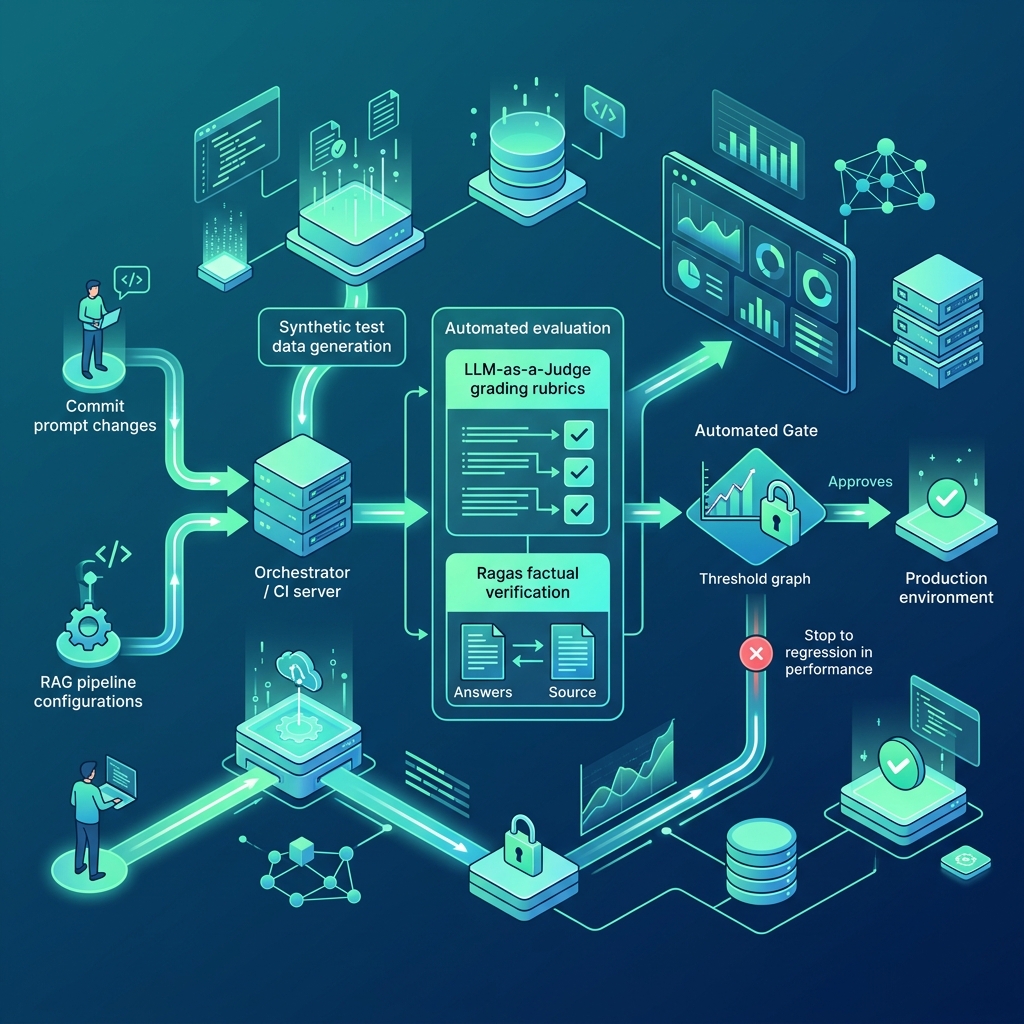
Continuous LLM Evals không phải là một bài kiểm tra đơn lẻ chạy trước ngày ra mắt sản phẩm, mà là một đường ống kỹ thuật đa tầng (multi-tier evaluation pipeline) vận hành xuyên suốt vòng đời phần mềm:
- Tầng tiền triển khai (Pre-deployment Gating in CI/CD): Mỗi khi kỹ sư thay đổi một câu lệnh prompt, tinh chỉnh tham số temperature, cập nhật thuật toán RAG hoặc đổi mô hình nền tảng, một bộ kiểm thử tự động gồm hàng ngàn trường hợp (synthetic test dataset) sẽ lập tức được kích hoạt. Nếu điểm số chất lượng rơi xuống dưới ngưỡng quy định (regression threshold), PR sẽ bị khóa tự động.
- Bộ đánh giá tự động đa chiều (LLM-as-a-Judge & Rubrics): Sử dụng các mô hình suy luận mạnh mẽ để đóng vai trò 'giám khảo' (Evaluator) chấm điểm các mô hình phục vụ theo bảng tiêu chí chuẩn hóa (rubrics). Các khía cạnh đánh giá bao gồm:
- Độ trung thực dữ liệu (Faithfulness): Câu trả lời có bám sát ngữ cảnh tài liệu trích xuất (grounded context) hay tự bịa đặt thông tin?
- Mức độ liên quan (Answer Relevance): Câu trả lời có giải quyết đúng trọng tâm câu hỏi của người dùng không?
- Độ an toàn và tính độc hại (Toxicity & Jailbreak Resistance): Khả năng chống đỡ các cuộc tấn công prompt injection và không phát ngôn thiên kiến.
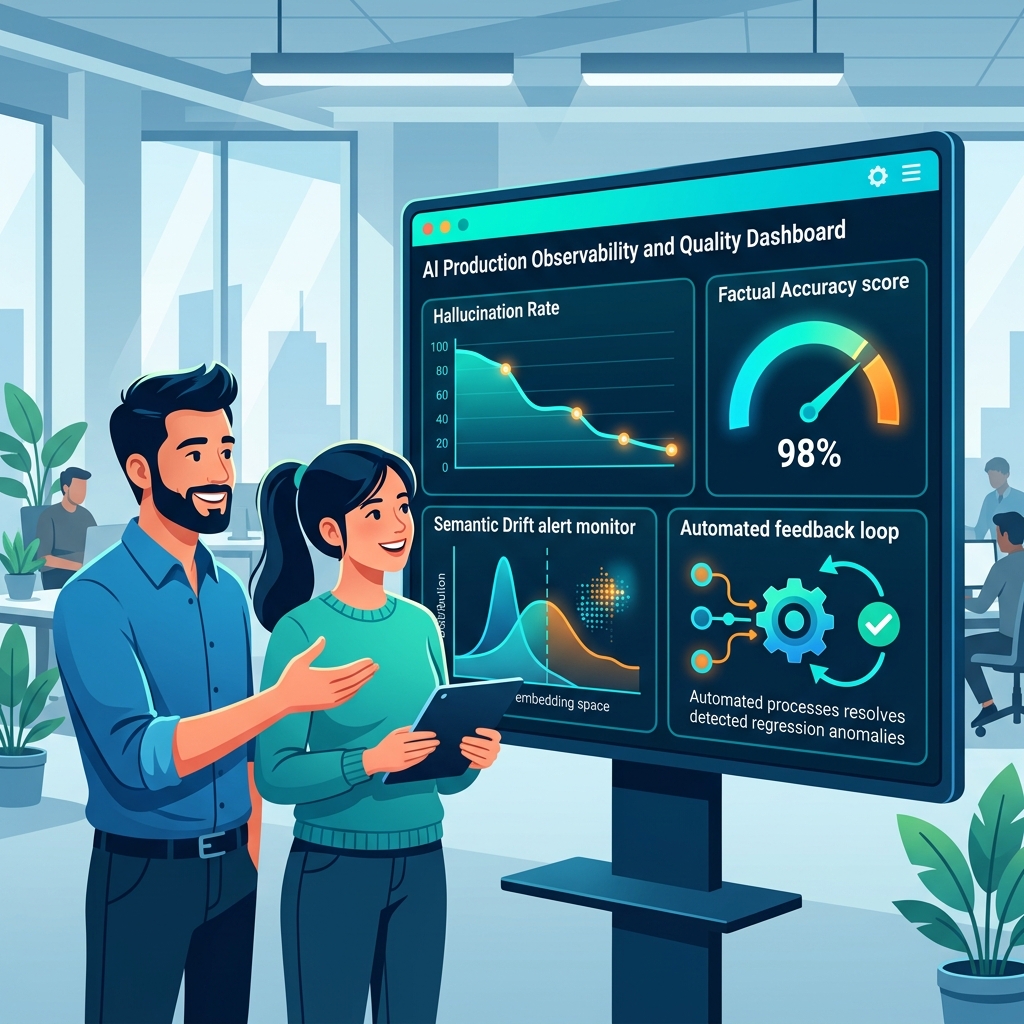
- Giám sát trực tiếp trên Production (Online Evals & Observability): Lấy mẫu ngẫu nhiên (sampling) 5% - 10% các tương tác thực tế của người dùng mỗi ngày để đưa qua bộ lọc Evals thời gian thực, giúp phát hiện sớm các dị biệt ngữ nghĩa và suy giảm chất lượng trước khi khách hàng kịp phàn nàn.
3. Lợi ích đo lường bằng các con số thực tế năm 2026
Các tổ chức công nghệ tiên phong triển khai hệ thống Continuous Evals đã thu được những kết quả kinh tế và vận hành ấn tượng:
- Độ chính xác tương đồng chuyên gia đạt 88% - 93%: Các khung đánh giá tự động kết hợp rubric chi tiết đạt mức độ tương đồng (alignment) lên tới 88% đến 93% so với kết quả đánh giá thủ công của các chuyên gia con người, trong khi giúp cắt giảm tới 95% chi phí và thời gian rà soát.
- Cắt giảm 65% thời gian phát hiện lỗi hồi quy: Đường ống Continuous Evals tích hợp CI/CD giúp đội ngũ kỹ thuật phát hiện và ngăn chặn 65% các lỗi suy luận hồi quy (prompt regressions) ngay tại khâu commit mã nguồn, triệt tiêu nguy cơ phát hành bản cập nhật lỗi ra thị trường.
- Giảm 80% sự cố nghiêm trọng (Severity-1 Incidents): Nhờ cơ chế giám sát tỷ lệ ảo giác liên tục trên production, số lượng sự cố AI đưa ra lời khuyên sai lệch cho khách hàng đã giảm hơn 80%.
- Nâng cao 40% chỉ số hài lòng khách hàng (CSAT): Độ tin cậy và tính ổn định nhất quán trong các câu trả lời giúp chỉ số hài lòng của người dùng cuối tăng vọt 40% trong vòng 3 tháng đầu triển khai.
4. Chiến lược triển khai thực chiến cho đội ngũ kỹ thuật
Để xây dựng một khung Continuous Evals vững chắc mà không làm tắc nghẽn tốc độ phát triển tính năng, các kỹ sư cần áp dụng các nguyên tắc cốt lõi sau:
- Xây dựng 'Tập dữ liệu vàng' (Golden Dataset) từ thực tế: Không phụ thuộc vào dữ liệu giả định; hãy liên tục trích xuất các câu hỏi khó, các trường hợp lỗi biên (edge cases) từ nhật ký production để bồi đắp vào bộ kiểm thử chuẩn.
- Áp dụng kiến trúc đa tầng (Tiered Evaluation): Chạy các kiểm thử ngữ nghĩa nhanh (như BERTScore, ROUGE, Regex rules) chỉ mất vài mili-giây cho toàn bộ các lượt commit. Chỉ kích hoạt các bộ kiểm thử LLM-as-a-Judge chuyên sâu tốn kém chi phí token đối với các nhánh hợp nhất chính (release branches).
- Biến Evals thành chỉ số văn hóa (Engineering Culture): Định lượng hiệu suất của AI thành các chỉ số KPI rõ ràng như tỷ lệ trung thực đạt trên 98%, độ chính xác đạt trên 95%. Mọi quyết định thay đổi mô hình hay tối ưu chi phí đều phải có bằng chứng từ bảng điều khiển Evals chứng minh không gây sụt giảm chất lượng.
5. Lời kết: Không có chất lượng bền vững nếu thiếu hệ thống đo lường liên tục
Trong kỷ nguyên phần mềm truyền thống, định luật nổi tiếng của Peter Drucker luôn đúng: 'Cái gì đo lường được thì mới quản trị được'. Trong kỷ nguyên trí tuệ nhân tạo, chân lý này càng trở nên bất biến gấp bội phần.
Continuous LLM Evals chính là chiếc phanh an toàn cho phép cỗ xe AI của doanh nghiệp lao đi với tốc độ tối đa mà không sợ mất lái. Đầu tư vào năng lực đánh giá liên tục ngay từ hôm nay chính là sự phân định rõ ràng nhất giữa một sản phẩm AI mang tính 'đồ chơi công nghệ' và một nền tảng AI doanh nghiệp thực thụ, đáng tin cậy và sẵn sàng mở rộng quy mô toàn cầu.
Đừng bao giờ để người dùng cuối trở thành đội ngũ kiểm thử chất lượng AI bất đắc dĩ của bạn. Hãy xây dựng hệ thống Continuous Evals tự động để kiểm soát chất lượng mã nguồn AI một cách chủ động và chuẩn xác.