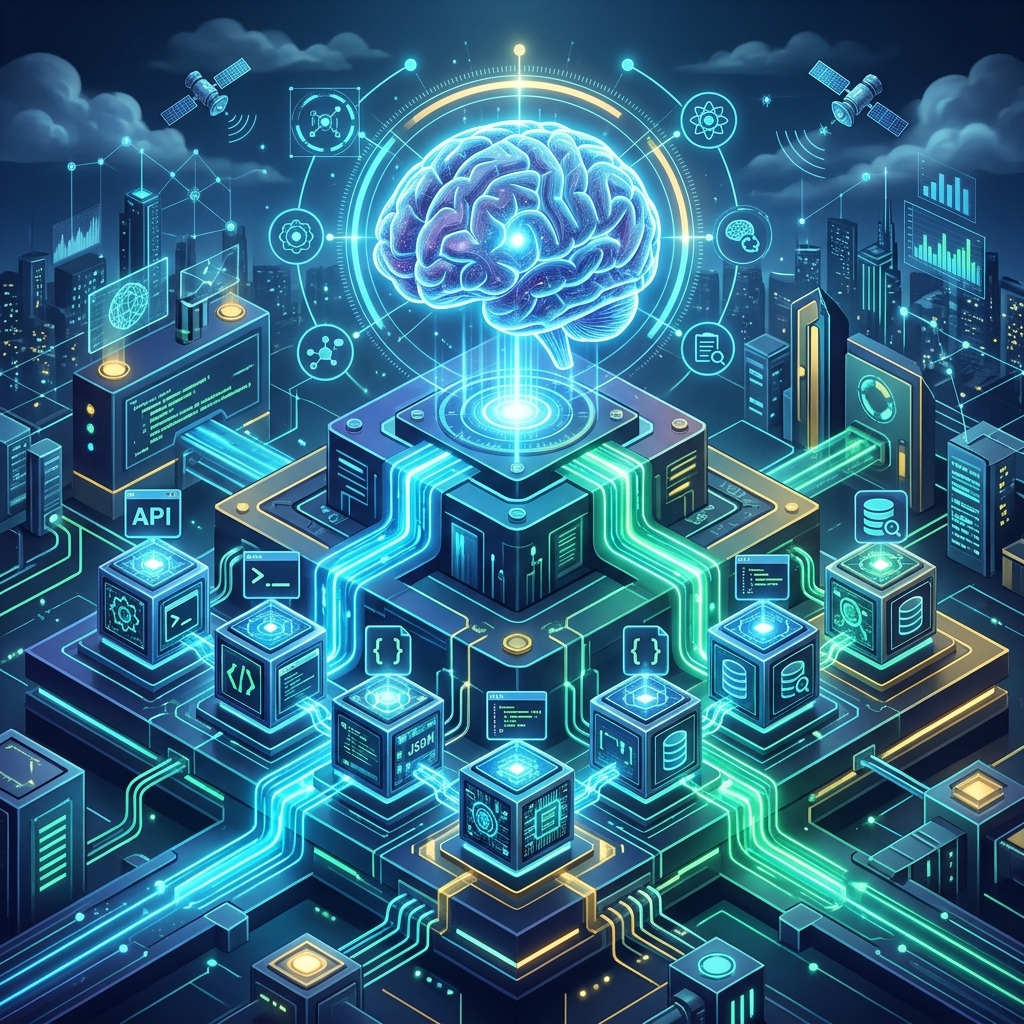
1. Bài toán 'Kinh tế học Tác nhân' (Agent Economics) và sự sụp đổ của tư duy dùng đại bác bắn chim sẻ
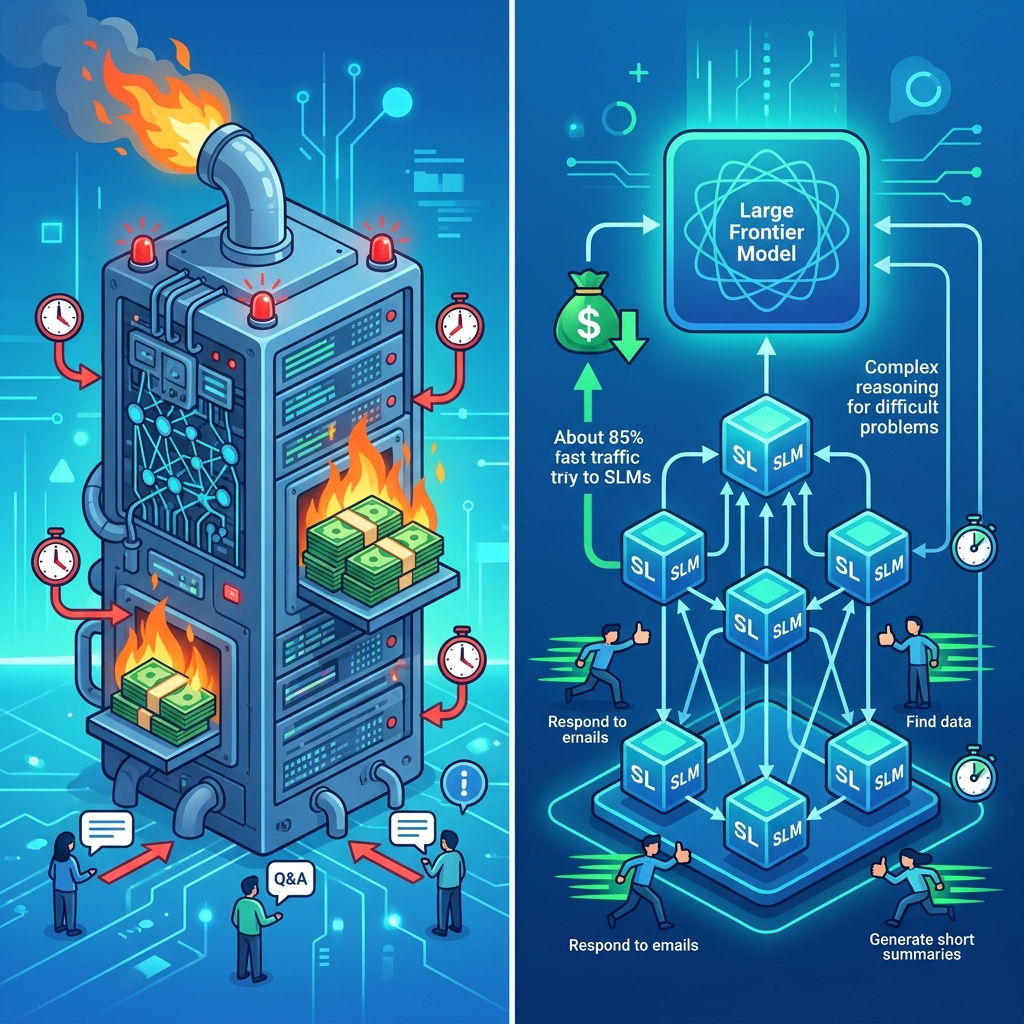
Bước vào quý 4 năm 2026, làn sóng ứng dụng Trí tuệ nhân tạo trong doanh nghiệp đã chuyển dịch hoàn toàn từ những khung chat hỏi đáp đơn lẻ sang các hệ thống Tác tử tự trị đa bước (Multi-step Autonomous Agents). Một yêu cầu tưởng chừng đơn giản từ người dùng như 'Hãy kiểm tra biến động doanh thu khu vực miền Nam tuần qua, đối chiếu với tồn kho và lên lịch họp khẩn với các giám đốc chi nhánh có tỷ lệ sụt giảm trên 15%' thực chất kích hoạt một vòng lặp từ 20 đến 40 bước gọi mô hình liên tiếp phía sau hậu trường.
Nếu doanh nghiệp sử dụng một mô hình tư duy biên giới khổng lồ (Frontier Reasoning Model với hàng trăm tỷ tham số) cho toàn bộ 40 bước này, hóa đơn API đám mây sẽ phình to theo cấp số nhân và thời gian chờ đợi có thể kéo dài hàng phút. Phân tích nhật ký vận hành thực tế năm 2026 chỉ ra một sự thật đáng kinh ngạc: trong một chu trình làm việc của AI Agent, có tới 80% đến 85% các bước xử lý chỉ là những tác vụ kỹ thuật mang tính thủ tục như phân loại ý định (intent classification), chuyển đổi định dạng JSON, trích xuất trường dữ liệu, kiểm tra cú pháp SQL hoặc gọi hàm API (tool calling).
Việc bắt một mô hình suy luận khổng lồ phải thực hiện việc đóng gói chuỗi JSON chẳng khác nào 'dùng đại bác để bắn chim sẻ' – vừa lãng phí tài nguyên tính toán, vừa làm tăng độ trễ không cần thiết. Chính áp lực về chi phí vận hành (OpEx) đã thúc đẩy sự ra đời của chuẩn mực kiến trúc quan trọng nhất cuối năm 2026: Kiến trúc Tác tử Phân tầng (Tiered Agent Architecture).
2. Giải phẫu Kiến trúc Tác tử Phân tầng: Sự phối hợp nhịp nhàng giữa 'Bộ não Chiến lược' và 'Đội quân Thực thi'
Thay vì phụ thuộc vào một mô hình duy nhất, Tiered Agent Architecture phân tách hệ thống AI thành một tháp năng lực gồm 3 tầng rõ rệt, nơi mỗi kích thước mô hình đảm nhận đúng sở trường tối ưu của mình:
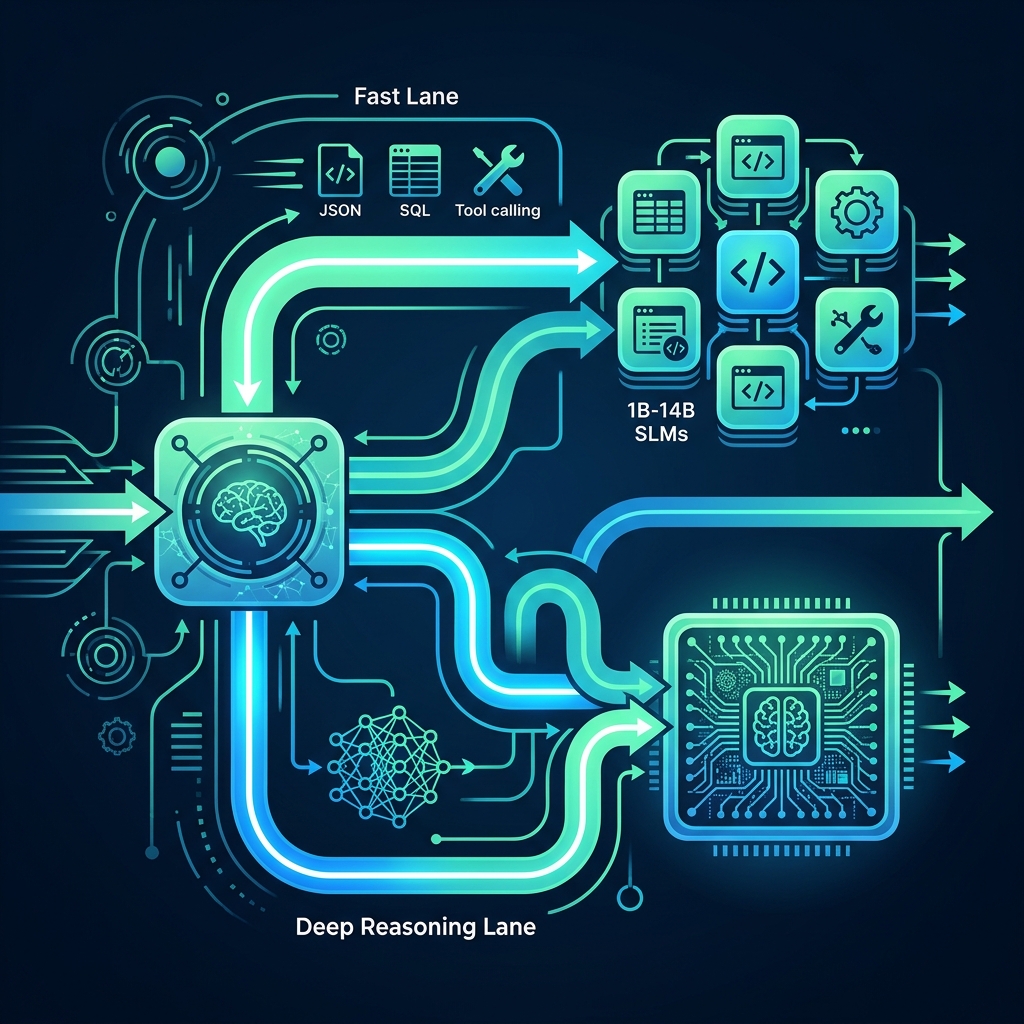
- Tầng 1 - Bộ điều phối & Định tuyến ngữ nghĩa siêu tốc (Semantic Router & Triage Layer): Sử dụng các mô hình nhúng (Embedding models) hoặc SLM siêu nhỏ dưới 1B tham số để phân tích yêu cầu đầu vào chỉ trong dưới 15 mili-giây, xác định độ phức tạp và phân luồng tác vụ tức thì.
- Tầng 2 - Lập kế hoạch & Suy luận chiến lược (Strategic Orchestrator - Frontier Tier): Chỉ chiếm khoảng 15% - 20% tổng số lượt gọi. Tầng này sử dụng các mô hình tư duy biên giới mạnh mẽ nhất để giải quyết các yêu cầu mơ hồ, phân rã mục tiêu lớn thành cây kế hoạch chi tiết (DAG workflow), xử lý các tình huống ngoại lệ chưa có tiền lệ và đưa ra phán đoán cuối cùng.
- Tầng 3 - Thực thi tác vụ cấu trúc (Specialized Execution Squad - SLM Tier 1B-14B): Đảm nhận 80% - 85% khối lượng công việc nặng nhọc. Các Mô hình Ngôn ngữ Nhỏ (Small Language Models từ 1B đến 14B tham số như Qwen 3.5, Llama 8B, Phi-4, Gemma 3) được tinh chỉnh chuyên sâu (fine-tuned) cho từng công cụ cụ thể: một SLM chuyên viết truy vấn SQL, một SLM chuyên chuẩn hóa JSON schema, và một SLM chuyên tóm tắt tài liệu RAG.
3. Tại sao các SLM (1B-14B) lại đánh bại mô hình lớn trong khâu thực thi công cụ?
Nhiều người lầm tưởng rằng sử dụng mô hình nhỏ là chấp nhận đánh đổi chất lượng để lấy giá rẻ. Tuy nhiên, các số liệu thực nghiệm trong môi trường sản xuất năm 2026 đã chứng minh điều ngược lại đối với các tác vụ có ràng buộc schema chặt chẽ:
- Độ chính xác ép khuôn JSON đạt 97.4%: Các bài kiểm thử chuẩn hóa năm 2026 cho thấy một mô hình SLM 7B-8B được tinh chỉnh bằng kỹ thuật LoRA trên tập dữ liệu API nội bộ đạt độ chính xác tuân thủ cấu trúc JSON và gọi hàm lên tới 97.4%, vượt qua cả các mô hình đa dụng khổng lồ vốn thường mắc lỗi 'nói thêm lời dẫn giải thừa thãi' làm gãy bộ phân tích cú pháp (parser).
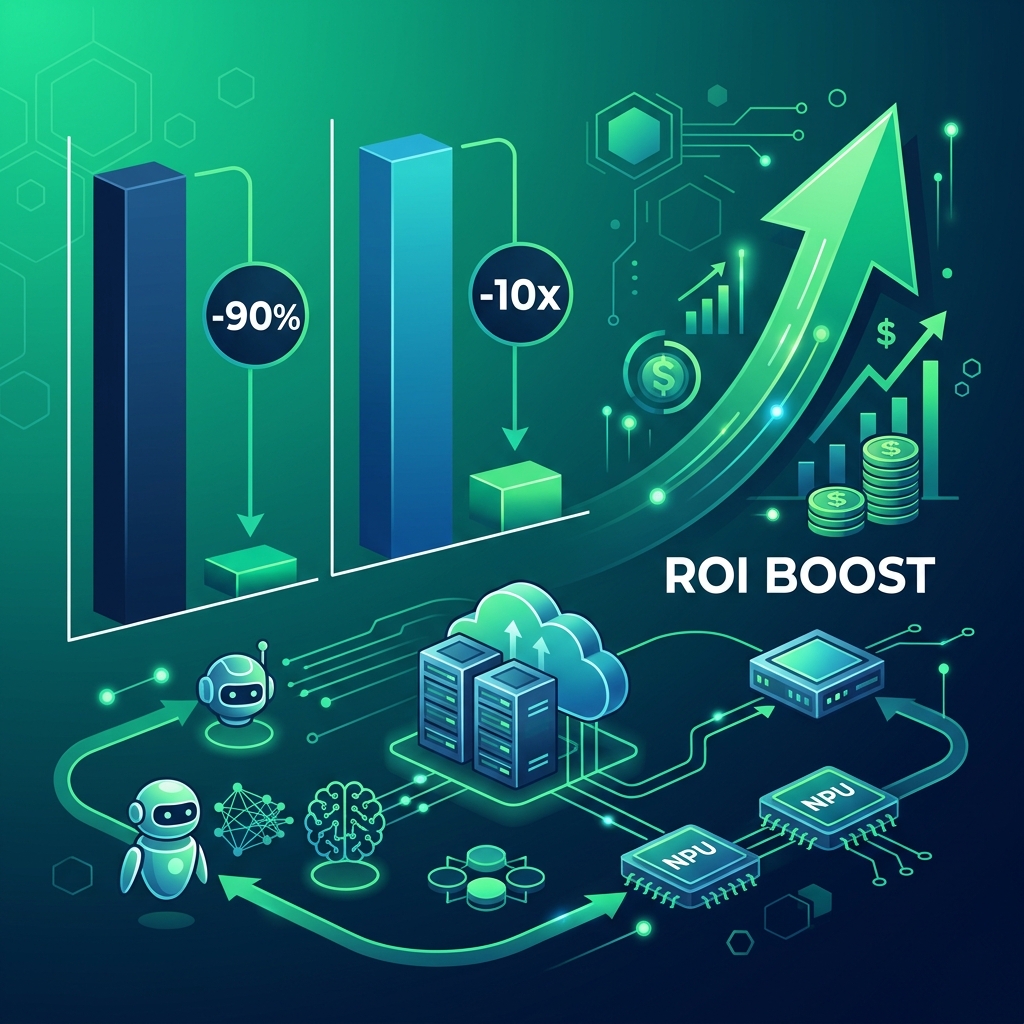
- Cắt giảm 85% đến 92% chi phí vận hành: Chi phí suy luận cho một triệu token trên các mô hình SLM nhỏ thấp hơn từ 15 đến 30 lần so với mô hình biên giới. Khi chuyển 85% khối lượng bước thực thi sang tầng SLM, tổng hóa đơn vận hành hệ thống Agent của doanh nghiệp giảm trung bình từ 85% đến 92%.
- Tăng tốc độ phản hồi gấp 10 - 25 lần: Nhờ kích thước trọng số gọn nhẹ nằm gọn trong bộ nhớ băng thông cao (HBM/VRAM), tốc độ sinh token của các SLM đạt từ 150 đến 300 tokens/giây, giúp giảm độ trễ toàn trình của các chuỗi tác vụ dài từ hàng chục giây xuống chỉ còn 1.5 - 3 giây.
- Làn sóng dịch chuyển của 78% CTO toàn cầu: Khảo sát 500 Giám đốc Công nghệ (CTO) vào quý 4/2026 ghi nhận 78% các tổ chức công nghệ đã chính thức từ bỏ kiến trúc đơn mô hình để chuyển sang mô hình phân tầng Hybrid Tiered Stack.
- Bảo mật dữ liệu tại biên (90% Data Sovereignty): Các mô hình SLM 1B-8B có thể triển khai trực tiếp trên cụm máy chủ nội bộ (On-premise) hoặc NPU thiết bị đầu cuối, giúp doanh nghiệp giảm 68% băng thông đám mây và giữ lại tới 90% dữ liệu nghiệp vụ nhạy cảm bên trong tường lửa công ty.
4. Chiến lược 4 bước triển khai Tiered Agent Architecture cho doanh nghiệp
Để thiết lập thành công kiến trúc tác tử phân tầng mà không làm phức tạp hóa việc quản trị mã nguồn, đội ngũ kỹ sư AI có thể áp dụng lộ trình thực chiến sau:
- Bước 1 - Kiểm toán và phân loại nhật ký Prompt (Prompt Telemetry Audit): Thu thập toàn bộ các bước gọi LLM hiện tại của hệ thống Agent, phân nhóm thành hai loại: Tác vụ đòi hỏi tư duy mở (Reasoning-heavy) và Tác vụ chuyển đổi cấu trúc (Schema/Tool-heavy).
- Bước 2 - Áp dụng Chưng cất Tri thức (Knowledge Distillation): Sử dụng chính dữ liệu đầu ra chất lượng cao của mô hình Frontier làm tập dữ liệu chuẩn (Golden Dataset) để tinh chỉnh (fine-tune) các mô hình SLM 3B - 8B mã nguồn mở.
- Bước 3 - Thiết lập Cổng Định tuyến Dự phòng (Fallback Routing Gate): Cấu hình cơ chế kiểm tra tự động (validator). Nếu đầu ra của SLM không vượt qua bước kiểm tra JSON schema hoặc có điểm tự tin (confidence score) thấp, hệ thống tự động leo thang (escalate) yêu cầu đó lên mô hình Frontier ở Tầng 2 xử lý.
- Bước 4 - Tối ưu hóa phục vụ mô hình (vLLM & Speculative Decoding): Triển khai cụm SLM trên các engine suy luận tốc độ cao như vLLM hoặc TensorRT-LLM kết hợp định량 hóa 4-bit/8-bit (FP8/AWQ) để tối đa hóa thông lượng xử lý đồng thời.
5. Lời kết: Tương lai của AI thực dụng và hiệu quả bền vững
Sự trưởng thành của ngành kỹ nghệ Trí tuệ nhân tạo vào cuối năm 2026 được đánh dấu bằng sự lên ngôi của chủ nghĩa thực dụng kỹ thuật (Pragmatic Engineering). Sức mạnh của một hệ thống AI doanh nghiệp không còn được đo bằng việc bạn thuê mô hình đắt đỏ nhất thế giới, mà được đo bằng sự tinh tế trong cách bạn phối hợp một dàn nhạc gồm những mô hình có kích thước khác nhau.
Kiến trúc Tác tử Phân tầng (Tiered Agent Architecture) chính là chìa khóa vàng giải quyết triệt để bài toán tiến thoái lưỡng nan giữa Trí thông minh, Độ trễ và Chi phí, mở đường cho các doanh nghiệp triển khai hàng ngàn AI Agent hoạt động liên tục 24/7 với hiệu suất kinh tế vượt trội.
Đừng bắt một nhà bác học phải ngồi gõ từng dòng biên lai kế toán. Hãy để mô hình tư duy lớn làm nhạc trưởng hoạch định chiến lược, và trao phần thực thi chuẩn xác, thần tốc cho đội ngũ SLM chuyên biệt.
DÀNH RIÊNG CHO GIÁO VIÊN TIN HỌC & TRƯỜNG HỌC
Combo Phần Mềm Phòng Máy Tin Học Mạng LAN (Không Cần Internet - 1 Máy Chủ Quản Lý Toàn Bộ Lớp)
• SpaceTyper LAN: Game thi đấu luyện gõ 10 ngón thời gian thực, bảng xếp hạng trực tiếp trên máy chiếu, chống rớt điểm khi F5.
• WebTrợGiảng LAN: Xem video bài giảng LAN mượt mà + Thi trắc nghiệm bấm giờ, tự động chấm điểm xuất Excel, nạp đề từ Word trong 5 giây.