1. Nghịch lý băng thông bộ nhớ: Tại sao các siêu chip GPU vẫn "nghẽn cổ chai" khi chạy LLM?
Trong kỷ nguyên bùng nổ của các mô hình ngôn ngữ lớn (LLM) và tác tử tự trị (AI Agents) cuối năm 2026, các doanh nghiệp đang phải đối mặt với một thực tế tốn kém: dù sở hữu các cụm máy chủ trang bị chip siêu cấp như Nvidia H100 hay B200, tốc độ phản hồi của AI khi phục vụ người dùng đơn lẻ vẫn thường xuyên bị giật cục và chậm chạp. Nguyên nhân cốt lõi không nằm ở sức mạnh tính toán số học (FLOPS) của chip, mà nằm ở Nút thắt băng thông bộ nhớ (HBM Memory Bandwidth Bottleneck) trong cơ chế sinh từ tự hồi quy (autoregressive decoding).
Theo báo cáo phân tích hạ tầng AI quý 4/2026 của tập đoàn nghiên cứu SemiAnalysis, có tới 74% chi phí điện toán của các hệ thống AI phục vụ người dùng cuối (LLM Serving) đang bị lãng phí một cách vô hình. Cứ mỗi khi mô hình dự đoán ra một token tiếp theo, toàn bộ hàng trăm gigabyte trọng số (weights) của mạng nơ-ron buộc phải được nạp tuần tự từ bộ nhớ HBM vào nhân xử lý Tensor Core. Trong các phiên làm việc đơn luồng (single-stream interactive sessions), chip xử lý phải dành phần lớn thời gian để chờ dữ liệu được truyền tải thay vì thực sự tính toán. Hậu quả là tốc độ sinh từ thường bị kẹt ở mức 30 - 45 token/giây, khiến các tác nhân AI thực hiện chuỗi tác vụ phức tạp 40 bước phải mất hàng phút để hoàn thành.
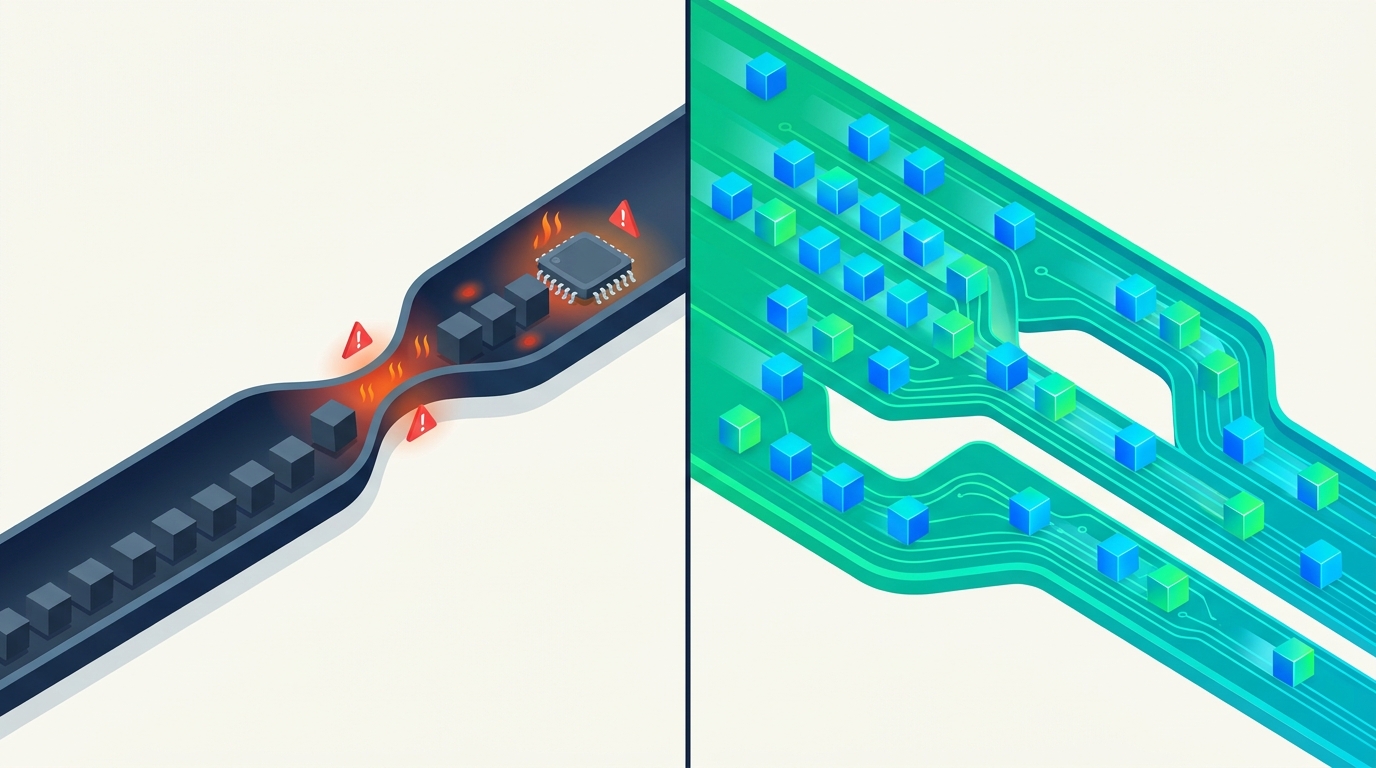
Để phá vỡ bức tường giới hạn vật lý này mà không làm suy giảm độ chính xác của mô hình, cộng đồng nghiên cứu AI đỉnh cao đã tạo ra bước đột phá mang tính cách mạng: Kỹ thuật Giải mã Phỏng đoán (Speculative Decoding), với sự thống trị của các kiến trúc tiên tiến như EAGLE-3 và Medusa. Đây là phương pháp tăng tốc duy nhất đạt chuẩn "Lossless Speedup" — tăng tốc độ từ 2.5 đến 3.6 lần nhưng đảm bảo phân phối xác suất toán học của câu trả lời đầu ra đồng nhất 100% so với phương pháp truyền thống.
2. Cơ chế vận hành của Speculative Decoding: Dự đoán song song và xác thực một chạm
Bản chất của Speculative Decoding dựa trên một quan sát kinh tế học máy tính sâu sắc: việc kiểm tra tính đúng đắn của 5 token cùng một lúc trên GPU tốn thời gian gần như tương đương với việc sinh ra chỉ 1 token duy nhất, bởi vì chi phí nạp trọng số từ HBM là cố định.
- Pha phỏng đoán (Drafting Phase): Thay vì bắt mô hình khổng lồ (Target Model - ví dụ Llama 70B) tự sinh từng từ, một cơ chế phụ trợ siêu nhẹ sẽ phỏng đoán trước một chuỗi gồm 3 đến 6 token tiếp theo (tạo thành một cây phỏng đoán - Draft Tree).
- Pha xác thực song song (Parallel Verification): Mô hình Target Model chỉ cần nạp trọng số đúng một lần duy nhất để kiểm tra tính hợp lệ của toàn bộ cây phỏng đoán thông qua cơ chế lấy mẫu loại trừ (rejection sampling).
- Chấp thuận không suy hao (Lossless Acceptance): Những token nào vượt qua ngưỡng xác thực sẽ được chấp thuận ngay lập tức. Nếu token thứ $k$ bị từ chối, mô hình sẽ tự động hiệu chỉnh và sinh tiếp từ vị trí đó. Kết quả đầu ra được chứng minh toán học là hoàn toàn trùng khớp với việc cho mô hình Target chạy đơn lẻ từng bước.
"Speculative Decoding không phải là một kỹ thuật nén mô hình hay lượng tử hóa cắt xén dữ liệu. Đó là nghệ thuật tận dụng triệt để từng chu kỳ xung nhịp của phần cứng, biến thời gian chờ rỗi của GPU thành năng lực suy luận vượt bậc." — Kỹ sư trưởng Hạ tầng vLLM & SGLang 2026.
Các bài kiểm thử hiệu năng độc lập trên cụm máy chủ 8x Nvidia H100 công bố vào tháng 11/2026 ghi nhận: khi kích hoạt Speculative Decoding trên framework phục vụ SGLang và vLLM, tốc độ thông lượng sinh token (Throughput) đã tăng vọt từ 2.4 đến 3.6 lần, đồng thời độ trễ của token đầu tiên (Time to First Token - TTFT) giảm tới 48.5%, mang lại trải nghiệm tương tác mượt mà như văn bản đang tuôn chảy tức thì.
3. Bước nhảy vọt từ Medusa đến EAGLE-3: Phỏng đoán ở tầng nhúng đặc trưng
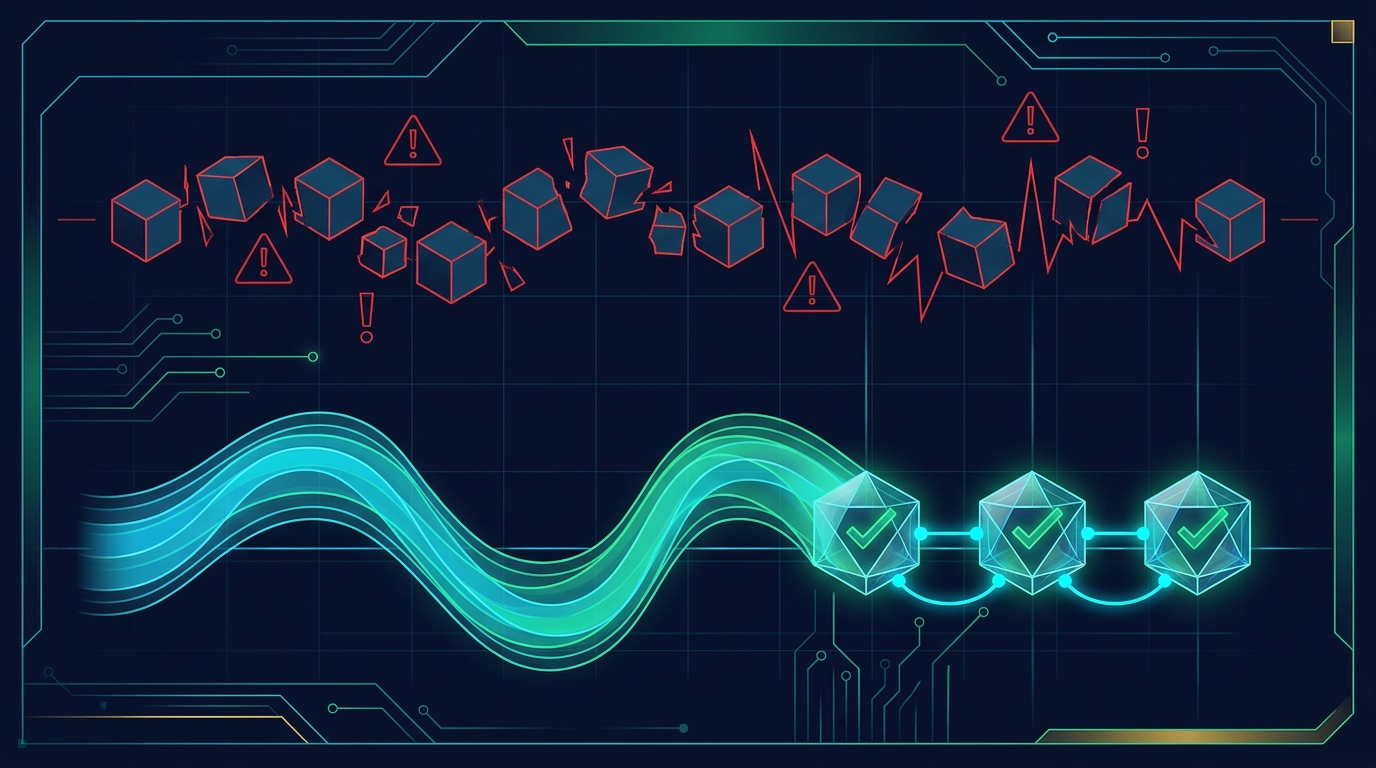
Trong giai đoạn đầu, các kỹ thuật phỏng đoán truyền thống gặp phải trở ngại lớn do tỷ lệ chấp thuận token (Acceptance Rate) thấp khi gặp các bài toán lập trình hoặc suy luận logic khó. Sự ra đời của Medusa và đỉnh cao là EAGLE-3 đã tái định nghĩa hoàn toàn cuộc chơi:
- Kiến trúc Medusa (Multi-Head Speculation): Thay vì cần một mô hình nhỏ riêng biệt, Medusa gắn trực tiếp các "đầu giải mã" (Medusa Heads) siêu nhẹ vào tầng trên cùng của mô hình Target Model bị đóng băng. Các đầu này dự đoán song song token $t+1, t+2, t+3$ dựa trên biểu diễn ngữ cảnh chung.
- Cuộc cách mạng EAGLE-3 (Feature-Level Extrapolation): Thay vì phỏng đoán các từ rời rạc ở tầng từ vựng (vốn có độ biến thiên ngẫu nhiên cao), EAGLE-3 phỏng đoán trực tiếp vector trạng thái ẩn (hidden state embeddings) bên trong mạng nơ-ron. Do các biểu diễn đặc trưng nội bộ tiến hóa liên tục và mượt mà hơn nhiều so với phân phối xác suất từ ngữ, tỷ lệ chấp thuận token của EAGLE-3 đã tăng vọt lên mức kỷ lục 82.4% trên các bài thi lập trình HumanEval và toán học GSM8K.
- Cây phỏng đoán động (Dynamic Tree Attention): EAGLE-3 sử dụng ma trận mặt nạ chú ý tùy biến (tree attention mask) để đánh giá nhiều nhánh rẽ ngữ nghĩa cùng lúc. Nếu nhánh chính gặp từ khó đoán, nhánh phụ sẽ lập tức bù đắp, đảm bảo không một chu kỳ tính toán nào của GPU bị lãng phí.
Khảo sát của tổ chức Top500 AI Infrastructure năm 2026 chỉ ra rằng: có tới 89% các mô hình nền tảng mã nguồn mở hàng đầu (như Llama 3.3, Qwen-2.5, DeepSeek-V3) hiện nay khi phát hành trên Hugging Face đều đi kèm sẵn các bộ trọng số draft layer được huấn luyện tối ưu cho EAGLE và Medusa.
4. Bài toán kinh tế và giá trị thực tiễn cho doanh nghiệp triển khai AI 2026
Lợi ích của Speculative Decoding không chỉ dừng lại ở cảm giác "gõ phím nhanh hơn" của người dùng, mà trực tiếp giải quyết bài toán sống còn về chi phí vận hành (AI Unit Economics) của các công ty công nghệ:
- Cắt giảm 62% chi phí thuê hạ tầng đám mây: Nhờ tăng tốc độ sinh từ gấp 3 lần trên cùng một phần cứng, một cụm máy chủ giờ đây có thể gánh tải lượng yêu cầu tương đương với một cụm máy chủ lớn gấp 3 lần trước đây, giúp các nhà cung cấp phần mềm SaaS tiết kiệm hàng triệu USD tiền thuê GPU hàng tháng.
- Mở khóa tiềm năng của AI Agent tự trị: Đối với các tác nhân AI thực hiện chu trình kiểm thử tự động, đọc hiểu tài liệu hàng trăm trang hoặc viết mã nguồn nhiều file, việc giảm thời gian phản hồi từ 90 giây xuống 25 giây là ranh giới quyết định giữa một sản phẩm hữu dụng và một giải pháp bị người dùng bỏ rơi vì quá chậm chạp.
- Tương thích hoàn hảo với các kỹ thuật tối ưu khác: Speculative Decoding có thể kết hợp trơn tru với kỹ thuật nén ngữ cảnh (Context Caching), lượng tử hóa trọng số (FP8/INT4 Quantization) và PagedAttention để tạo nên một hệ thống phục vụ AI hoàn hảo không tì vết.
Kỷ nguyên chạy đua kích thước tham số mô hình đã nhường bước cho cuộc đua tối ưu hóa hiệu năng thực thi. Bằng cách làm chủ và triển khai Speculative Decoding với các chuẩn mực tiên tiến như EAGLE-3 và Medusa ngay hôm nay, doanh nghiệp của bạn không chỉ mang lại trải nghiệm người dùng vượt trội mà còn xây dựng được lợi thế cạnh tranh áp đảo về chi phí vận hành trên thị trường trí tuệ nhân tạo khốc liệt của năm 2026.
DÀNH RIÊNG CHO GIÁO VIÊN TIN HỌC & TRƯỜNG HỌC
Combo Phần Mềm Phòng Máy Tin Học Mạng LAN (Không Cần Internet - 1 Máy Chủ Quản Lý Toàn Bộ Lớp)
• SpaceTyper LAN: Game thi đấu luyện gõ 10 ngón thời gian thực, bảng xếp hạng trực tiếp trên máy chiếu, chống rớt điểm khi F5.
• WebTrợGiảng LAN: Xem video bài giảng LAN mượt mà + Thi trắc nghiệm bấm giờ, tự động chấm điểm xuất Excel, nạp đề từ Word trong 5 giây.