1. Bức tường dữ liệu tiền huấn luyện và sự dịch chuyển lịch sử sang 'Tư duy Hệ thống 2'
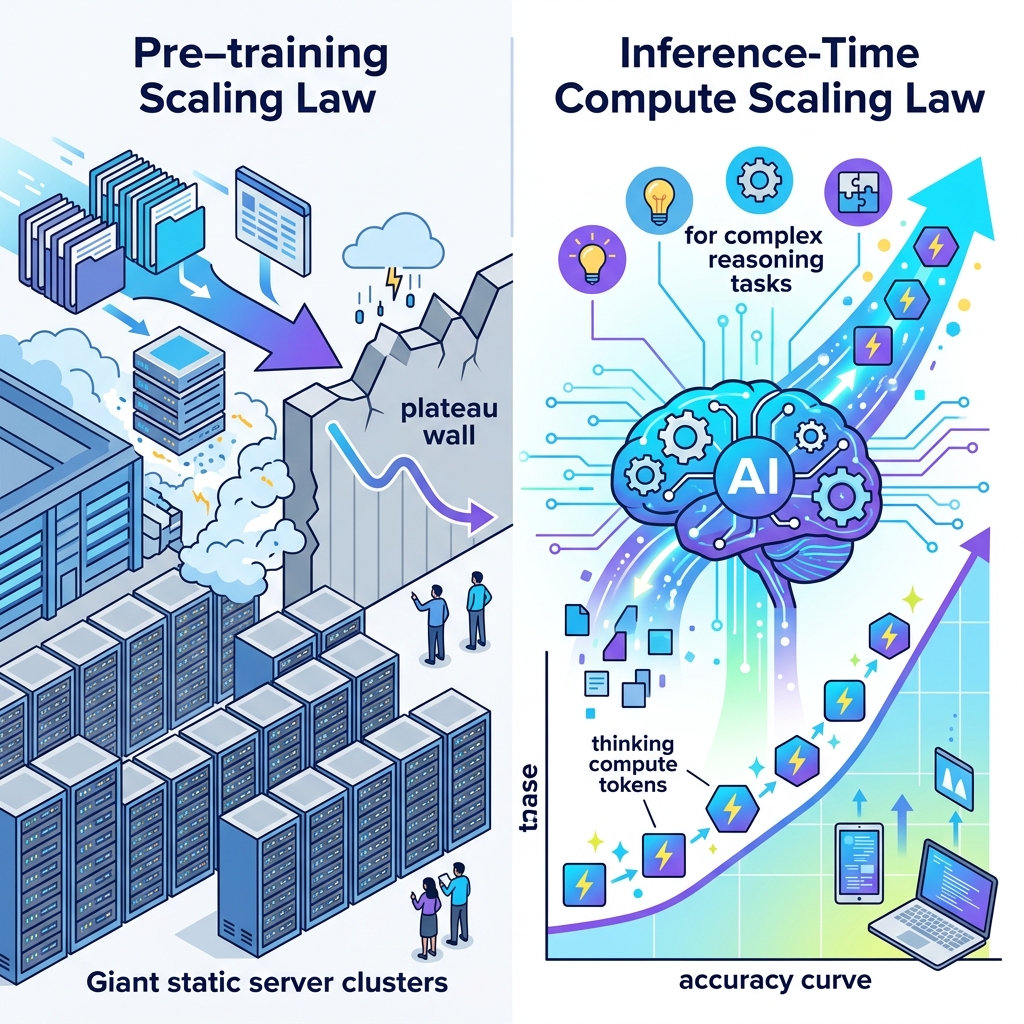
Trong suốt một thập kỷ qua, ngành công nghiệp Trí tuệ nhân tạo phát triển dựa trên một niềm tin gần như tuyệt đối vào Định luật Mở rộng Tiền huấn luyện (Pre-training Scaling Law): muốn mô hình thông minh hơn, chỉ cần gom nhiều văn bản trên Internet hơn và lắp ghép các cụm siêu máy tính hàng trăm ngàn GPU để huấn luyện mô hình có số lượng tham số khổng lồ hơn. Thế nhưng, bước sang năm 2026, nhân loại đã chạm tới giới hạn vật lý của nguồn dữ liệu văn bản chất lượng cao do con người tạo ra, trong khi chi phí huấn luyện một mô hình nền tảng mới đã vượt ngưỡng hàng tỷ đô la nhưng hiệu suất tăng thêm lại bắt đầu chững lại.
Ngay tại thời điểm bức tường tiền huấn luyện xuất hiện, một cuộc cách mạng kiến trúc mới đã bùng nổ và định hình lại toàn bộ bản đồ công nghệ cuối năm 2026: Điện toán Thời gian Suy luận (Inference-Time Compute / Test-Time Scaling). Thay vì bắt mô hình phát ra câu trả lời ngay lập tức theo phản xạ bản năng (tương ứng với Tư duy Hệ thống 1 - Nhanh và Cảm tính theo lý thuyết của giải Nobel Kinh tế Daniel Kahneman), các mô hình thế hệ mới được thiết kế để tạm dừng, suy ngẫm, lập luận đa chiều và tự phản biện trước khi đưa ra kết luận cuối cùng (Tư duy Hệ thống 2 - Chậm và Thấu đáo).
Sự chuyển dịch này đã chứng minh một định luật mới đầy quyền năng: Chất lượng trí tuệ của AI giờ đây không chỉ phụ thuộc vào quy mô mô hình lúc huấn luyện, mà tỷ lệ thuận với lượng tài nguyên tính toán được cấp phát cho mô hình suy nghĩ ngay tại thời điểm giải quyết vấn đề.
2. Giải mã cơ chế Deliberative Reasoning: Bên trong 'Tập giấy nháp nội bộ' của AI có gì?
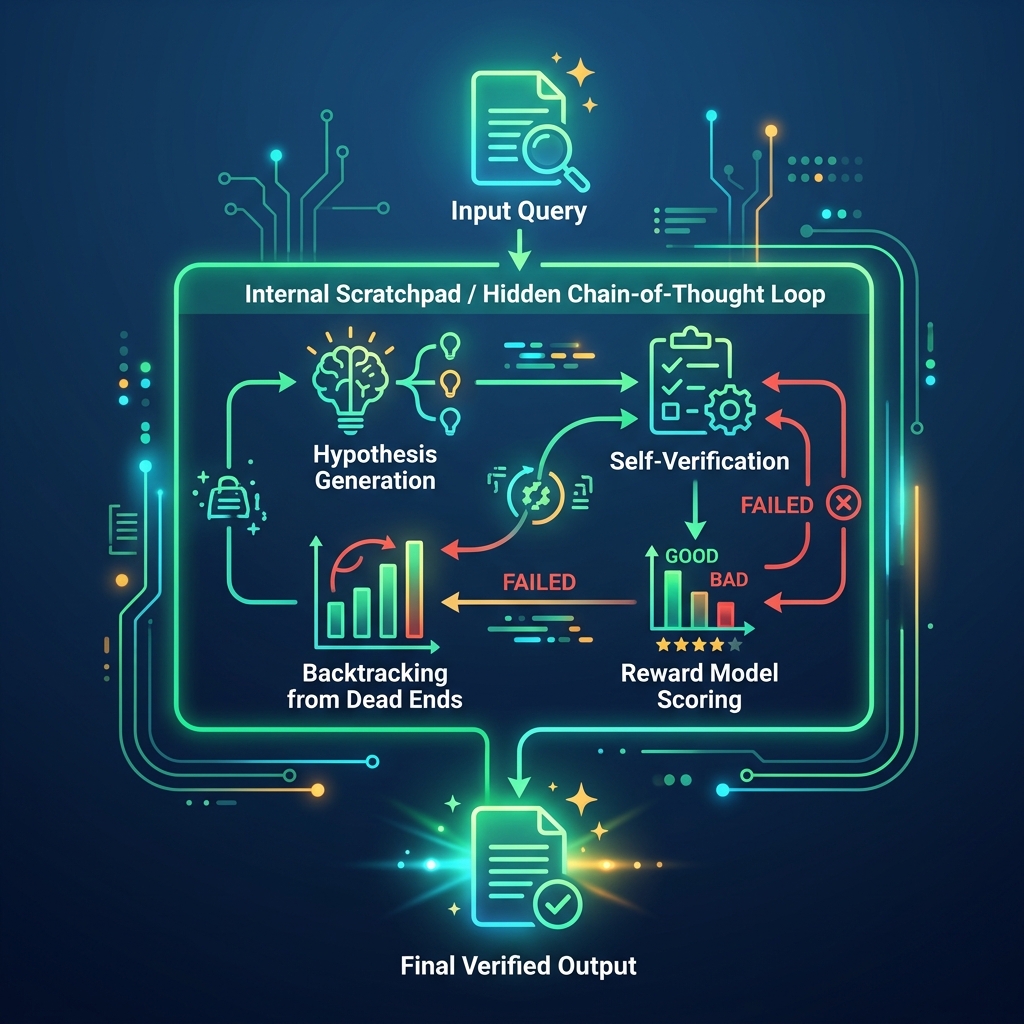
Khác với kỹ thuật viết câu lệnh 'Hãy suy nghĩ từng bước một' (Prompted Chain-of-Thought) sơ khai của những năm trước, các mô hình suy luận bản địa (Native Reasoning Models) năm 2026 được huấn luyện trực tiếp bằng phương pháp Học tăng cường với Phần thưởng Có thể Xác minh (Reinforcement Learning with Verifiable Rewards - RLVR) trên hàng triệu bài toán toán học, mã nguồn và logic hình thức.
Khi nhận được một bài toán kiến trúc hệ thống phức tạp, bên trong 'tập giấy nháp nội bộ' (internal scratchpad / thinking tokens) của mô hình diễn ra một quy trình tư duy có chủ đích (Deliberative Reasoning) gồm 4 giai đoạn tinh vi:
- Phân rã giả thuyết và Tìm kiếm cây tư duy (Tree-of-Thought Exploration): Mô hình không đi theo một đường thẳng duy nhất mà tự vạch ra 3 đến 5 hướng tiếp cận khả thi khác nhau để giải quyết bài toán.
- Tự kiểm chứng trung gian (Process Reward Verification): Sau mỗi bước lập luận hoặc mỗi đoạn code nháp, mô hình tự đóng vai người phản biện để kiểm tra tính hợp lệ toán học và phát hiện các mâu thuẫn logic tiềm ẩn.
- Quay lui khi gặp ngõ cụt (Autonomous Backtracking): Nếu phát hiện giả thuyết A dẫn đến xung đột bộ nhớ hoặc vi phạm điều kiện biên, mô hình sẽ tự ghi nhận 'Hướng đi này không khả thi vì lý do X, hãy quay lại bước 2 và thử hướng tiếp cận B'.
- Tổng hợp và Tinh chỉnh đầu ra (Synthesis & Refinement): Chỉ khi đã tìm ra lời giải vượt qua toàn bộ các bài kiểm tra nội bộ, mô hình mới chắt lọc và trình bày câu trả lời sạch sẽ, rõ ràng nhất cho người dùng cuối.
3. Sức mạnh của Test-Time Scaling qua những con số thực nghiệm chấn động
Các báo cáo nghiên cứu và kiểm thử thực tế vào quý 4/2026 đã cung cấp những minh chứng đắt giá về sức mạnh cũng như thách thức kinh tế của Điện toán Thời gian Suy luận:
- Mô hình nhỏ thắng mô hình lớn gấp 10 - 14 lần: Nghiên cứu thực nghiệm chứng minh rằng khi được cấp ngân sách tính toán suy luận (test-time compute) hợp lý, một mô hình suy luận gọn nhẹ có thể đạt độ chính xác giải toán và viết code vượt qua một mô hình tiền huấn luyện tĩnh có số lượng tham số lớn hơn gấp 10 đến 14 lần.
- Bước nhảy vọt độ chính xác từ 32% lên 86.5%: Trên các bộ quy chuẩn khắc nghiệt nhất về toán học Olympic (AIME) và sửa lỗi phần mềm thực tế (SWE-bench Verified), việc kích hoạt Deliberative Reasoning giúp tỷ lệ giải quyết thành công tăng vọt từ mức 32% của LLM truyền thống lên tới 86.5%.
- Cái bẫy 'Suy nghĩ quá mức' (Overthinking Cost 8x - 15x): Nếu cấu hình cứng nhắc mức tư duy tối đa cho mọi câu hỏi thông thường (như dịch thuật đơn giản hay tóm tắt đoạn văn ngắn), mô hình sẽ sinh ra hàng ngàn thinking tokens không cần thiết, làm chi phí API và độ trễ phản hồi đội lên gấp 8 đến 15 lần.
- Tiết kiệm 62% chi phí nhờ Ngân sách Tư duy Động: Các doanh nghiệp triển khai bộ điều phối Dynamic Thinking Budget (tự động cấp từ 0 đến 32,000 thinking tokens tùy độ khó) đã cắt giảm được 62% tổng chi phí suy luận trong khi vẫn bảo toàn 98.2% độ chính xác đỉnh cao ở các bài toán khó.
- Hơn 80% API mô hình biên giới chuẩn hóa tham số tư duy: Đến tháng 10/2026, trên 80% các nền tảng AI thương mại hàng đầu đã cung cấp tham số điều khiển trực tiếp (`reasoning_effort` hoặc `thinking_budget`), biến việc quản trị ngân sách tư duy thành kỹ năng thiết kế hệ thống tiêu chuẩn.
4. Nghệ thuật quản trị 'Ngân sách Tư duy' (Thinking Budget) cho Kỹ sư Hệ thống
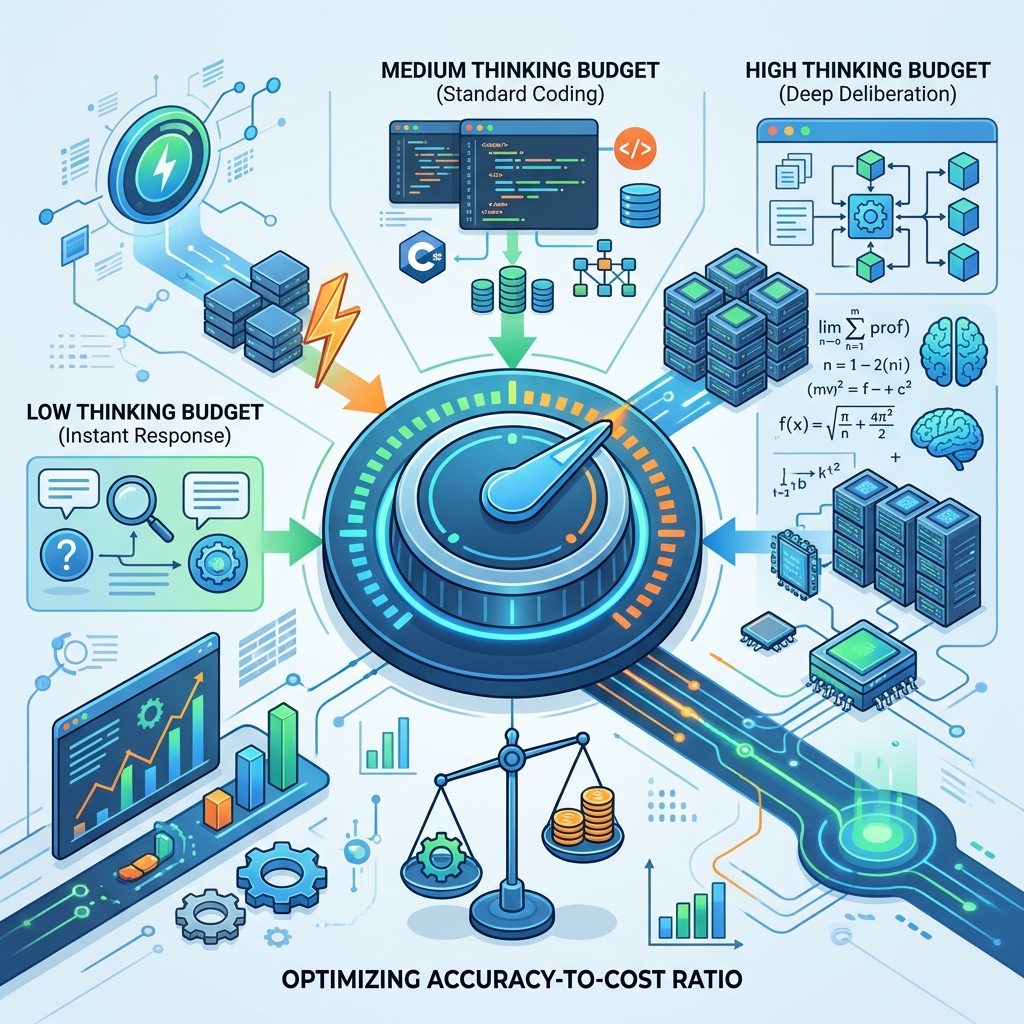
Trong kỷ nguyên Inference-Time Compute, kỹ sư AI không còn chỉ tối ưu hóa câu lệnh đầu vào, mà phải thiết kế cơ chế phân bổ ngân sách tư duy thông minh theo 3 cấp độ linh hoạt:
- Chế độ Phản xạ Tức thì (Zero / Minimal Thinking - 0 đến 256 tokens): Áp dụng cho các tác vụ phân loại nhanh, trích xuất thực thể, trò chuyện giao tiếp thông thường và định tuyến yêu cầu, đảm bảo phản hồi dưới 500ms.
- Chế độ Suy luận Tiêu chuẩn (Medium Thinking - 1,024 đến 4,096 tokens): Dành cho các tác vụ viết hàm code nghiệp vụ, phân tích báo cáo tài chính đa bảng biểu và tổng hợp tài liệu RAG có đối chiếu chéo.
- Chế độ Thẩm định Chuyên sâu (High / Deep Deliberation - 8,192 đến 32,000+ tokens): Kích hoạt cho các bài toán thiết kế kiến trúc phần mềm tổng thể, tìm lỗ hổng bảo mật phức tạp, chứng minh định lý hoặc lập kế hoạch chiến lược dài hạn, nơi độ chính xác tuyệt đối có giá trị cao hơn nhiều so với vài giây chờ đợi.
5. Lời kết: Khi thời gian suy ngẫm trở thành đơn vị đo lường trí tuệ mới
Điện toán Thời gian Suy luận đã mở ra một chương mới đầy cảm hứng cho trí tuệ nhân tạo: đưa cách thức tư duy của máy móc tiến gần hơn bao giờ hết tới phẩm chất quý giá nhất của trí tuệ con người – sự cẩn trọng, biết nghi ngờ bản thân và kiên trì tìm kiếm chân lý qua từng bước suy luận.
Làm chủ nghệ thuật điều phối Ngân sách Tư duy (Thinking Budget) chính là chìa khóa giúp các kỹ sư và doanh nghiệp khai thác trọn vẹn trí tuệ sâu sắc của các mô hình suy luận thế hệ mới mà vẫn kiểm soát hoàn hảo bài toán chi phí và tốc độ trên quy mô lớn.
Trí tuệ đích thực không nằm ở việc phản ứng nhanh đến mức nào trước một câu hỏi khó, mà nằm ở chiều sâu của sự suy ngẫm trước khi cất lời. Hãy cấp cho AI ngân sách tư duy xứng đáng với tầm vóc bài toán của bạn.
DÀNH RIÊNG CHO GIÁO VIÊN TIN HỌC & TRƯỜNG HỌC
Combo Phần Mềm Phòng Máy Tin Học Mạng LAN (Không Cần Internet - 1 Máy Chủ Quản Lý Toàn Bộ Lớp)
• SpaceTyper LAN: Game thi đấu luyện gõ 10 ngón thời gian thực, bảng xếp hạng trực tiếp trên máy chiếu, chống rớt điểm khi F5.
• WebTrợGiảng LAN: Xem video bài giảng LAN mượt mà + Thi trắc nghiệm bấm giờ, tự động chấm điểm xuất Excel, nạp đề từ Word trong 5 giây.